
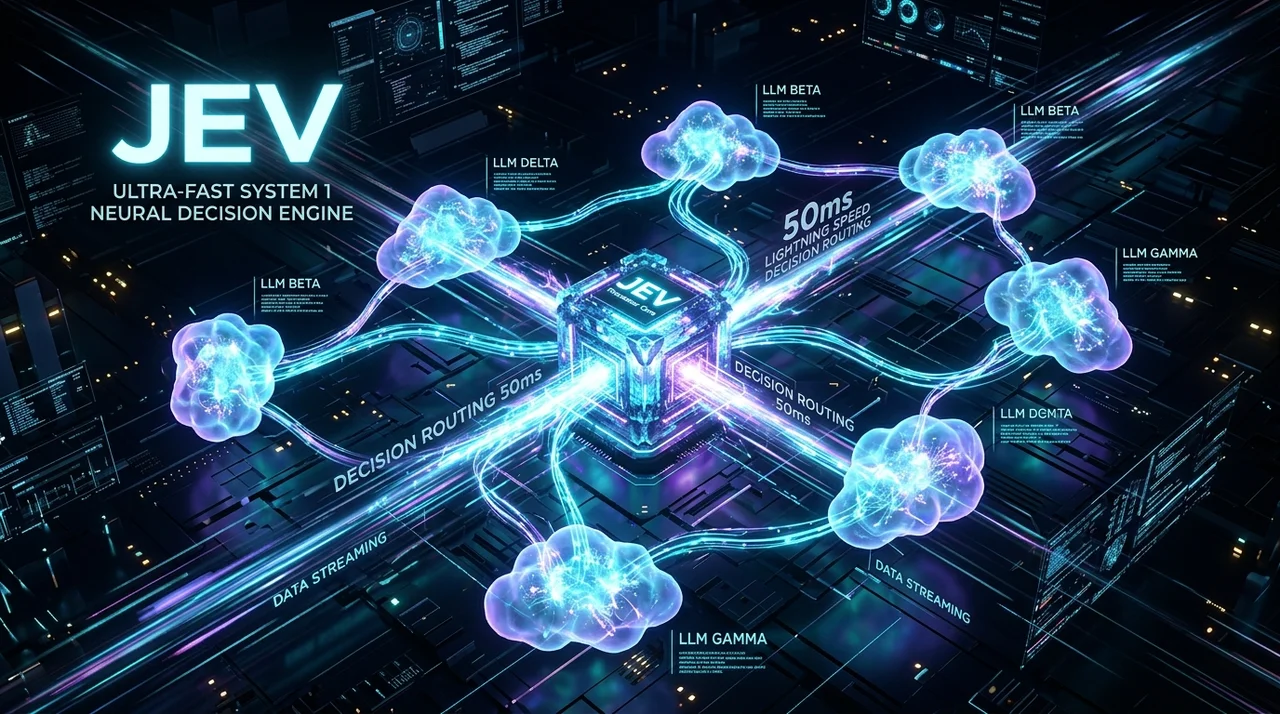
Jev چیست و چرا باید از آن استفاده کنیم؟
مصرف توکن برای تصمیمهای ساده را متوقف کنید. یک مدل تصمیمگیری سبک با تاخیر ۵۰ میلیثانیه میتواند بار مسیریابی عاملهای هوشمند شما را بدون هزینه و تاخیر توکنسازی بر عهده بگیرد.
غرق شدن در موج مدلهای جدید
هر هفته شاهد انتشار مدلهای زبانی بنیادین جدید هستیم. وزنهای محاسباتی جدید معرفی میشوند، پنجرههای کانتکست گسترش مییابند و دنبال کردن بنچمارکها تبدیل به کاری تماموقت شده است.
مدلهای مولد برای نوشتن کد، ایدهپردازی یا توضیح مفاهیم پیچیده فوقالعاده هستند. اما در معماریهای عملیاتی اغلب یک خطای بنیادین رخ میدهد: ما از مدلهای بزرگ اتورگرسیو (Autoregressive) به عنوان مسیریابهای عمومی سیستم استفاده میکنیم.
اگر یک عامل هوشمند صرفا باید بین دو ابزار یکی را انتخاب کند یا از درستی خروجی مطمئن شود، ارسال این درخواست به یک مدل ۷۰ میلیارد پارامتری به معنای انتظار ۸۰۰ تا ۲۰۰۰ میلیثانیهای برای استریم توکنها است. این تاخیر انباشته میشود و هزینه را بالا میبرد.
ایده طراحی Jev بسیار ساده و کاربردی است: تفکیک منطق تصمیمگیری و انتخاب مسیر از تولید متن.
Jev چیست؟
موتور Jev یک مدل تصمیمگیری سبک و غیراتورگرسیو است که به موازات مدلهای زبانی بزرگ فعالیت میکند.
این مدل متن تولید نمیکند، کد نمینویسد و تصویری نمیسازد. بلکه روی انتخابهای قطعی تمرکز دارد. با دریافت ورودی و مجموعهای از گزینهها، به یک پرسش پاسخ میدهد: گام بعدی چیست؟
flowchart LR
User([درخواست کاربر / رویداد]) --> Jev["موتور تصمیمگیری Jev\n(تاخیر حدود ۵۰ میلیثانیه)"]
Jev -- "اقدام سریع / ابزار محلی" --> Exec[اجرای ابزار محلی]
Jev -- "نیاز به استدلال و تولید متن" --> HeavyLLM["مدل زبانی سنگین\n(Claude / GPT / Gemini)"]
Exec --> Output([نتیجه نهایی])
HeavyLLM --> Output
از آنجا که Jev توکنها را کلمه به کلمه پیشبینی نمیکند، زمان پاسخدهی آن حدود ۵۰ میلیثانیه است. این سرعت بالا اجرای محلی روی پردازنده معمولی (CPU) و استفاده درون حلقههای سریع پردازشی را ممکن میسازد.
چرا سرعت مهم است: تمثیل شطرنج بولت
تفاوت سرعت را در بازیهای فوقسریع مانند شطرنج بولت میتوان دید؛ جایی که هر بازیکن برای کل بازی تنها یک تا سه دقیقه زمان دارد.
در شطرنج بولت فرصتی برای تامل طولانی وجود ندارد. اگر موتور برای تصمیمگیری ۲ ثانیه مکث کند، ساعت صفر میشود و بازی را میبازید. شما نیاز به تصمیمگیری آنی دارید.
همین وضعیت در سیستمهای بلادرنگ (Real-time) حاکم است: واکنش NPCها در موتورهای بازی، گیتهای امنیتی معاملات خودکار، یا رابطهای کاربری بلادرنگ. مدلهای اتورگرسیو برای این حلقههای فشرده کند هستند. موتور Jev با پاسخ ۵۰ میلیثانیهای پاسخگویی سیستم را در شرایط سخت حفظ میکند.
هدایت عاملهای هوشمند بدون تاخیر اضافه
همانطور که در مقاله قبلیام درباره جریان کاری توسعهدهندگان و هوش مصنوعی اشاره کردم، کنترل معماری سیستم یعنی استفاده هدفمند از ابزارها، نه پرتاب بیهدف پرامپتها به سوی مدلهای گرانقیمت.
هنگام هماهنگسازی سیستمهای چندعاملی (Multi-Agent) متوجه میشوید که بخش عمده گامهای اجرایی عاملها خلاقانه نیستند، بلکه وظایف مدیریتی و تفکیکی هستند:
- آیا دستور Bash با موفقیت اجرا شد؟
- آیا این درخواست به دیتابیس نیاز دارد یا جستجوی وب؟
- خروجی باید به کاربر بازگردد یا به عاملی دیگر ارسال شود؟
صدا زدن یک مدل زبانی سنگین فقط برای پاسخ به این پرسشها، هدر دادن بودجه توکن و ایجاد تاخیر نامطلوب است.
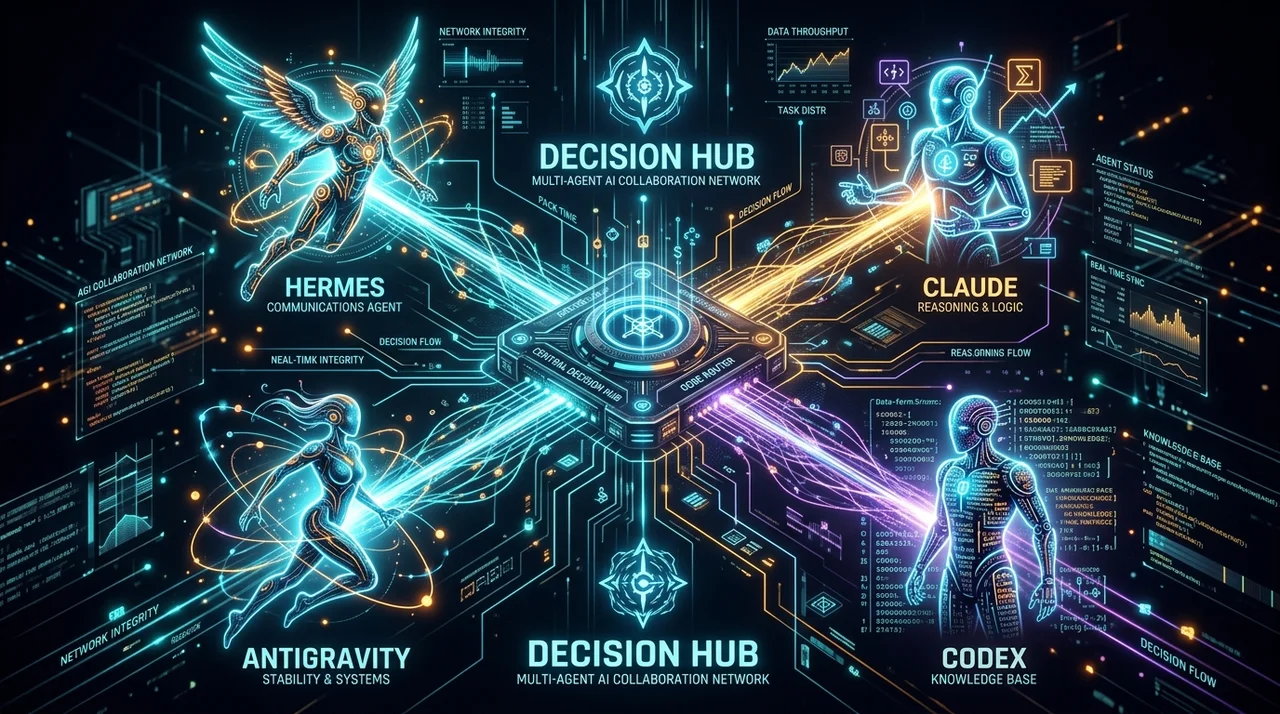
قرار دادن Jev در این پایپلاین مزایای متعددی دارد:
- تاخیر بسیار پایین: انشعابهای روتین به جای ۲ ثانیه در حدود ۵۰ میلیثانیه تصمیمگیری میشوند.
- کاهش شدید هزینهها: مدلهای سنگینی مثل Claude یا Codex فقط زمانی صدا زده میشوند که نیاز واقعی به نگارش متن یا تولید کد وجود داشته باشد.
- مسیریابی قطعی: چون Jev یک کلاسیفایر است نه تولیدکننده متن، خطاهایی مثل JSON ناقص یا توابع توهمی حذف میشوند.
مقایسه مدلهای زبانی مولد و موتور Jev
| ویژگی | مدلهای زبانی مولد (LLM) | موتور تصمیمگیری Jev |
|---|---|---|
| وظیفه اصلی | نگارش متن و تولید کد | دستهبندی و مسیریابی تصمیم |
| زمان پاسخ معمول | ۸۰۰ تا ۳۰۰۰ میلیثانیه | حدود ۳۰ تا ۵۰ میلیثانیه |
| قالب خروجی | رشتهای از توکنهای متنی | شاخص کلاس یا اکشن قطعی |
| منابع سختافزاری | حافظه GPU بالا | بسیار سبک (اجرای روان روی CPU) |
| مدل هزینه | محاسبه بر اساس توکن | سربار ناچیز به ازای درخواست |
| خطر توهم (Hallucination) | نیازمند گاردریلهای سنگین | صفر در انتخاب مسیر |
نمونه پیادهسازی عملی
در ادامه یک نمونه از بهکارگیری Jev به عنوان لایه غربالگری قبل از صدا زدن مدل اصلی آمده است:
from jev import DecisionEngine
from anthropic import Anthropic
jev = DecisionEngine(model="jev-fast-v1")
claude = Anthropic()
def handle_request(user_input: str):
# گام اول: بررسی سریع مسیر در ۵۰ میلیثانیه
decision = jev.decide(
input=user_input,
options=["cached_response", "direct_sql_query", "deep_llm_reasoning"]
)
# گام دوم: عمل بر اساس نتیجه
if decision.action == "cached_response":
return get_cache(user_input)
if decision.action == "direct_sql_query":
return query_db(decision.params)
# مدل سنگین فقط زمانی فراخوانی میشود که نیاز به تولید متن واقعی باشد
return claude.messages.create(
model="claude-3-7-sonnet",
prompt=user_input
)
در این معماری، مدل زبانی گرانقیمت هیچگاه دروازهبان نخستین سیستم نیست. Jev ورودی را ارزیابی میکند، کارهای روتین را بلافاصله تفکیک مینماید و فقط سناریوهای نیازمند پردازش عمیق را عبور میدهد.
جمعبندی
هر گامی در یک سیستم هوش مصنوعی به یک مدل چندصد میلیارد پارامتری نیاز ندارد. تفکیک تصمیمگیری از تولید محتوا، تاخیر را مهار میکند، از اتلاف توکن جلوگیری مینماید و سیستمهای چندعاملی را بلادرنگ و چابک نگه میدارد.
دیدگاهها
ارسال دیدگاه