
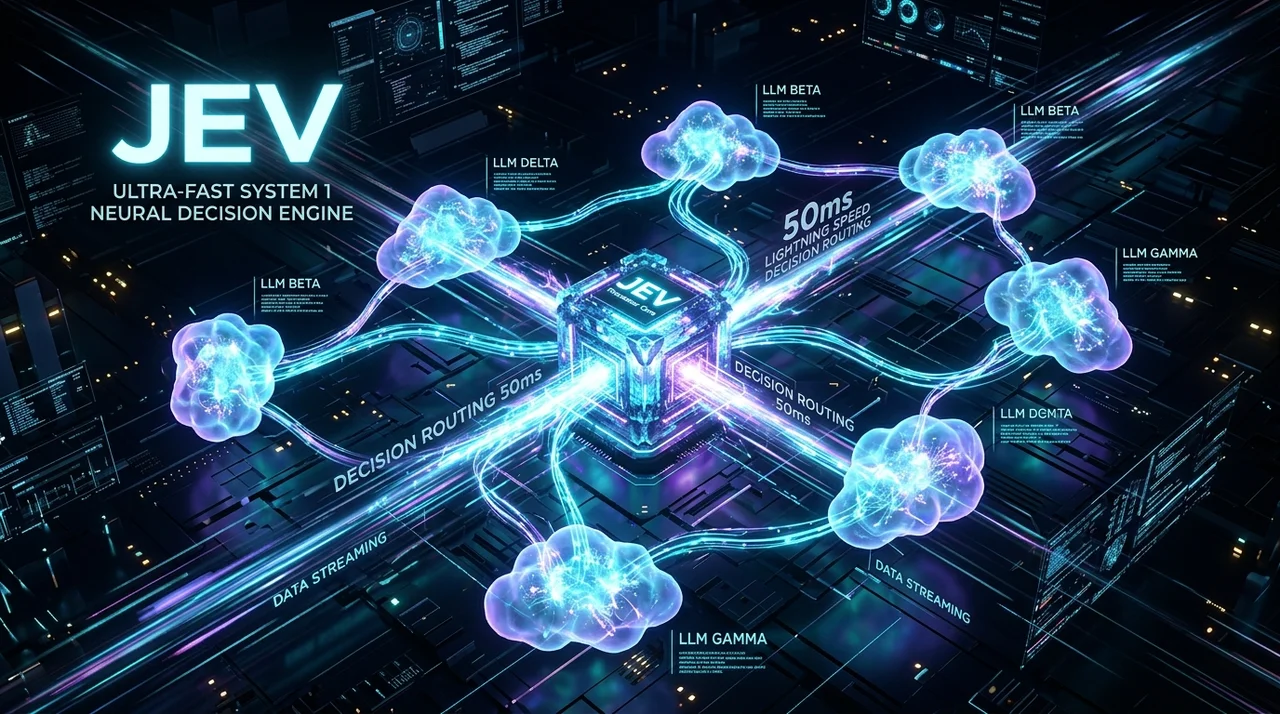
Was ist Jev und warum Sie es einsetzen sollten
Verschwenden Sie keine Token für einfache Routing-Entscheidungen. Ein kompaktes ~50ms-Entscheidungsmodell steuert Agenten und Pipelines ohne die Latenz und Kosten vollständiger Textgenerierung.
Flut neuer Modellveröffentlichungen
Wöchentlich erscheinen neue Foundation-Modelle. Gewichte werden aktualisiert, Kontextfenster vergrößert, und das Verfolgen von Benchmark-Ergebnissen gleicht einer Vollzeitaufgabe.
Generative Modelle eignen sich hervorragend zum Entwerfen von Code oder Erklären komplexer Zusammenhänge. In Produktions-Pipelines unterläuft Entwicklern jedoch oft ein grundlegender Fehler: Riesige autoregressive Modelle werden als universelle Router missbraucht.
Wenn ein KI-Agent lediglich zwischen zwei Werkzeugen wählen oder prüfen soll, ob eine Ausgabe valide ist, bedeutet ein Prompt an ein 70B-Modell oft 800ms bis zwei Sekunden Wartezeit auf das Token-Streaming. Diese Latenz summiert sich rasant, und die API-Kosten steigen.
Jev basiert auf einer klaren Trennung: Die Entscheidungslogik wird von der Textgenerierung entkoppelt.
Was ist Jev?
Jev ist ein kompaktes, nicht-autoregressives Entscheidungsmodell, das parallel zu großen Sprachmodellen läuft.
Es generiert keinen Fließtext, schreibt keinen Code und erzeugt keine Grafiken. Stattdessen verarbeitet es diskrete Auswahlen. Basierend auf einer Eingabe und einer Menge von Optionen beantwortet es genau eine Frage: Welche Aktion folgt als Nächstes?
flowchart LR
    User([Benutzeranfrage / Event]) --> Jev["Jev Decision Engine\n(~50ms Latenz)"]
    Jev -- "Schnelle Aktion / Lokales Tool" --> Exec[Lokale Tool-Ausführung]
    Jev -- "Komplexe Generierung erforderlich" --> HeavyLLM["Großes LLM\n(Claude / GPT / Gemini)"]
    Exec --> Output([Ergebnis])
    HeavyLLM --> Output
Da Jev Token nicht sequentiell Wort für Wort vorhersagt, liegt die Antwortzeit bei etwa 50 Millisekunden. Das ist schnell genug für die lokale Ausführung auf Standard-CPUs oder in engen Schleifen, in denen normale API-Aufrufe den gesamten Ablauf blockieren würden.
Warum Geschwindigkeit zählt: Das Bullet-Schach-Prinzip
Der Geschwindigkeitsunterschied zeigt sich deutlich in extrem schnellen Spielen wie Bullet-Schach, bei denen jeder Spieler nur ein bis drei Minuten Bedenkzeit für die gesamte Partie hat.
Beim Bullet-Schach bleibt keine Zeit für langes Zögern. Wenn eine Engine zwei Sekunden pausiert, um eine Antwort zu formulieren, läuft die Uhr ab. Man benötigt Reaktionen im Sekundenbruchteil.
Dieselbe Anforderung gilt für Echtzeitsysteme: Ob Reaktionen von NPCs in Game-Engines, automatisierte Absicherungen im Finanzhandel oder Benutzeroberflächen, die sich unmittelbar anfühlen müssen. Autoregressive Modelle sind für derart enge Schleifen schlicht zu träge. Jev liefert eine Aktion in ~50ms und hält das System reaktionsfähig.
Agenten betreiben ohne Latenz-Aufschlag
Wie ich in meinem früheren Artikel über Entwickler-Workflows und KI beschrieben habe, bedeutet architektonische Kontrolle, KI gezielt einzusetzen, anstatt blind Prompts auf jedes Problem zu werfen.
Bei der Koordination von Multi-Agenten-Systemen wie Hermes, Claude, Codex oder Antigravity wird schnell klar: Die meisten Zwischenschritte erfordern keine Kreativität. Es handelt sich um administrative Entscheidungen:
- War der Bash-Befehl erfolgreich?
- Erfordert diese Anfrage Datenbankzugriff oder Websuche?
- Geht die Ausgabe zurück an den Nutzer oder an einen Folgeagenten?
Ein vollständiges Frontier-Modell aufzurufen, nur um einen Status zu klassifizieren, erzeugt unnötige Wartezeit und verbraucht Token-Kontingente.
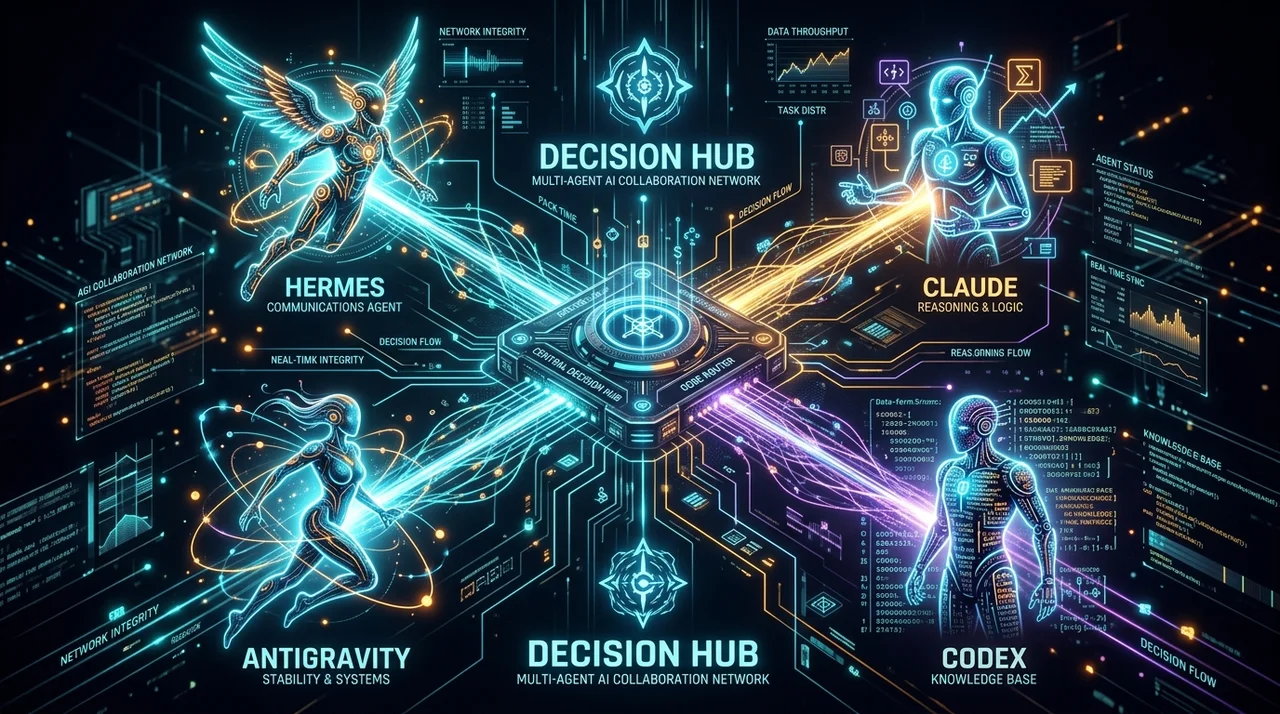
Die Einbindung von Jev in die Agentenarchitektur optimiert den Ablauf:
- Geringere Latenz: Routinemäßige Verzweigungen erfolgen in rund 50ms statt in zwei Sekunden.
- Niedrigere Kosten: Modelle wie Claude oder Codex werden nur aufgerufen, wenn tatsächlich Text oder Code generiert werden muss.
- Deterministisches Routing: Da Jev als Klassifikator fungiert, entfallen Parsing-Fehler, unvollständiges JSON oder halluzinierte Funktionsnamen.
Vergleich: Generative LLMs vs. Jev
| Merkmal | Generative LLMs | Jev Decision Engine |
|---|---|---|
| Hauptaufgabe | Text- und Codegenerierung | Klassifizierung und Aktions-Routing |
| Typische Antwortzeit | 800ms bis 3.000ms | Rund 30ms bis 50ms |
| Ausgabeformat | Generierter Token-Stream | Diskrete Aktion / Klassenindex |
| Hardware-Bedarf | Hoher GPU-Speicher | Sehr leichtgewichtig (CPU-tauglich) |
| Kostenstruktur | Abrechnung pro Token | Minimaler Overhead pro Anfrage |
| Halluzinationsrisiko | Benötigt Guardrails | Keines bei der Pfadauswahl |
Praktisches Integrationsbeispiel
Hier ist ein typisches Muster, um Jev als Filter vor ein Standard-LLM zu schalten:
from jev import DecisionEngine
from anthropic import Anthropic

jev = DecisionEngine(model="jev-fast-v1")
claude = Anthropic()

def handle_request(user_input: str):
    # Schritt 1: Schneller Routing-Check (~50ms)
    decision = jev.decide(
        input=user_input,
        options=["cached_response", "direct_sql_query", "deep_llm_reasoning"]
    )

    # Schritt 2: Verzweigung nach Entscheidung
    if decision.action == "cached_response":
        return get_cache(user_input)

    if decision.action == "direct_sql_query":
        return query_db(decision.params)

    # Das schwere Modell wird erst bei echtem Textgenerierungsbedarf gerufen
    return claude.messages.create(
        model="claude-3-7-sonnet",
        prompt=user_input
    )
In dieser Struktur ist das rechenintensive Modell kein Pauschal-Gatekeeper mehr. Jev prüft die Eingabe vorab, wickelt Standardroutinen direkt ab und leitet nur Anfragen weiter, die echte Sprachgenerierung erfordern.
Fazit
Nicht jeder Schritt in einer KI-Pipeline benötigt ein Modell mit Hunderten Milliarden Parametern. Durch die saubere Trennung von Entscheidungsfindung und Textgenerierung reduzieren Sie Latenzen, sparen Token und halten Multi-Agenten-Systeme dauerhaft schnell.
Kommentare
Einen Kommentar schreiben